Claude Code 团队如何做 Code Review
基于 Addy Osmani、Morgan Westlee Lunt、Qing Wang 的 Anthropic 技术文章整理;保留原始数据,并补充团队落地建议。英文原文
当 Claude Code 团队约 90% 的代码由 Claude 编写,传统 Code Review 面临一个直接问题:代码生产越来越快,人工逐行阅读还能跟上吗?
Anthropic 分享了阶段性结果:6 月至 9 月,Claude Code 仓库合并的 PR 数量翻了一倍多,同期需要回滚的比例下降超过 40%。与此同时,Anthropic 整体 monorepo 的日变更量从 5 月约 2,500 次增长到 9 月超过 30,000 次;这项统计不代表 Claude Code 独立仓库。
核心思路:让自动化检查覆盖大部分常规问题,把人的注意力留给高风险决策,并确保出错后可以快速回滚。
一、重新定义 Code Review
Code Review 原本有两项职责:上线前发现问题,以及在团队内部传递代码知识。
在 AI Coding 场景中,逐行阅读不再是衡量质量的最佳指标。更有价值的问题是:这次变更可能造成什么后果?哪些检查最容易发现风险?哪些判断必须由工程师完成?
这也让 Review 从 PR 末端的一道闸门,变成覆盖开发、审核、合并、发布与事故复盘的持续防线。
二、全流程:六层质量检查与回滚兜底
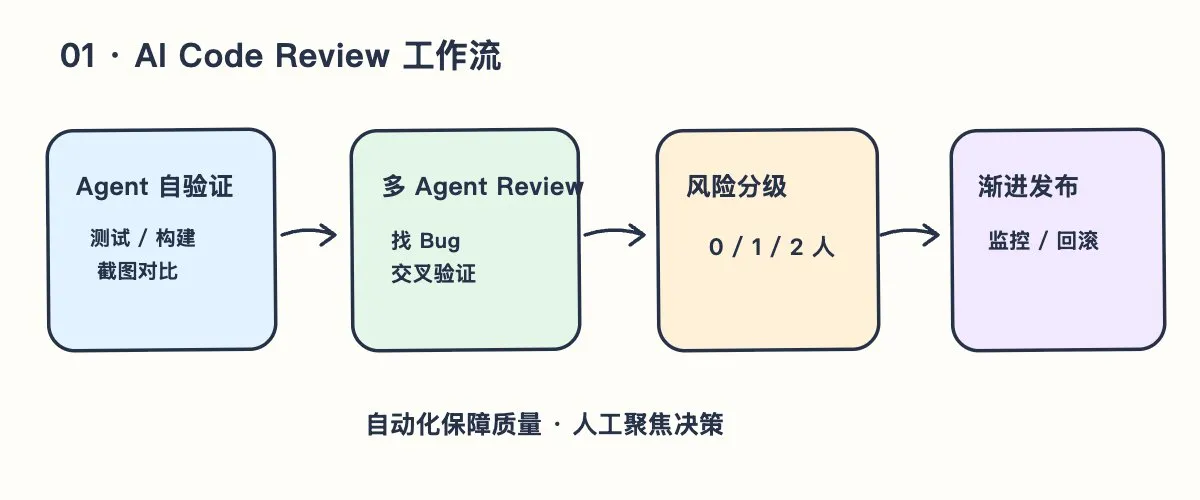
- PR 前:由 Agent 自验证
Agent 完成修改后先执行测试、构建、Lint、类型检查,UI 变更还可以进行截图与设计稿比对,再由一个全新上下文的子 Agent 审核 Diff。
要求 Agent 提供实际输出,而不只是声称“已完成”。CLAUDE.md 描述项目技术栈、约定和验证方式;REVIEW.md 由代码所有者描述失败模式、敏感路径、需要的证据及应当忽略的低价值问题。
- PR 阶段:多 Agent 审核
所有 PR 先经过 AI Code Review。多个 Agent 并行发现缺陷,再由另一组 Agent 验证与筛选结果,降低误报和重复评论。
审查重点是变更意图、系统影响及潜在回归。评论分为 Important、Nit、Pre-existing 等,避免将旧问题错误归因于当前作者。研究预览期间,内部 PR 收到实质性评论的比例从 16% 提升至 54%;这一数字不是 Bug 检出率。
- 安全 Review:可阻断合并
安全检查独立运行。未处理的安全或 Bug Review 发现必须修复,或者由作者给出明确理由后关闭线程。安全检查与常规代码质量检查形成互补。
- CI:验证代码可以运行
持续集成执行 Lint、类型检查、测试及构建。PR 还要写明验证方法和回滚方式,提交人对内容负责。
- 人工批准:随风险调整
不同代码变更的潜在影响不同,审核成本也需要相应调整。分类器依据变更内容定级,另一个分类器复核是否仍需人工介入。
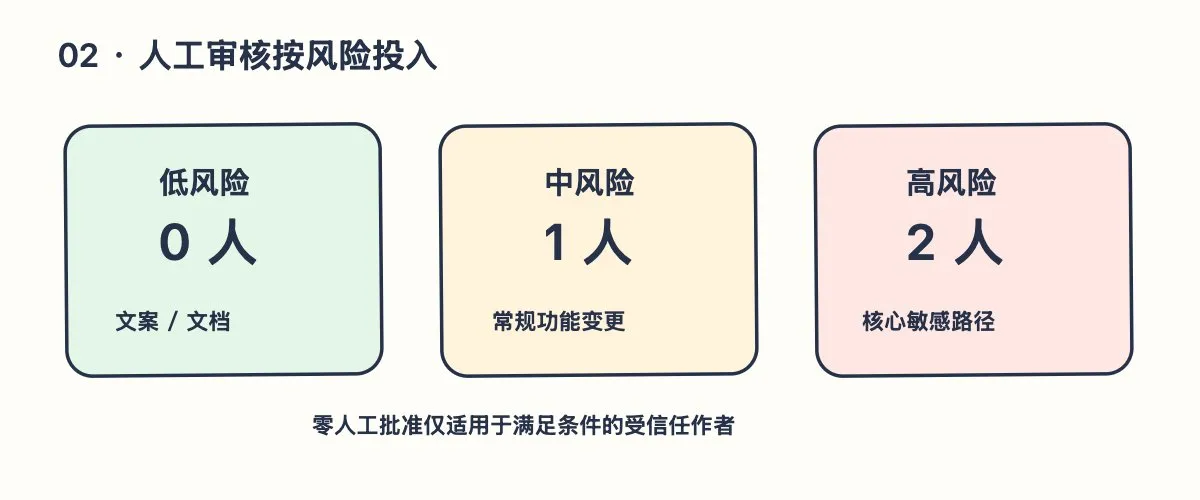
不同风险等级对应的人工批准人数,手绘示意
| 风险 | 场景示例 | 人工批准 |
|---|---|---|
| 低 | 文档、文案、内部功能、开关保护下的加性修改 | 符合条件时 0 人 |
| 中 | 常规产品变更、缓存、自动更新器、系统提示等 | 1 人 |
| 高 | 最高风险代码和指定的双人审核路径 | 2 人 |
零人工批准只适用于满足要求的受信任作者;敏感路径和 CI workflow 文件仍需人工审核。Agent 的批准不能替代人工批准。负责人可以计入所需的人数,但对结果仍须承担责任。批准绑定具体 Commit,关键变更后需要重新确认。
- 合并及发布:继续控制风险
Merge Queue 会针对待合入主分支的结果重新执行检查,避免两个分别通过 CI 的 PR 在合并后引入冲突。
新行为优先由内部员工使用,并通过 Feature Flag、latest 与 stable 通道逐步扩大覆盖范围。
- 回滚:最后一道防线
没有审核系统能发现所有问题。Feature Flag、监控、On-call 和快速回滚用于控制线上影响;事故复盘则追问“本该由哪一层检查发现这个问题”。
原文明确提到,团队尚未实现一种在事故或回滚指标恶化时自动收紧批准门槛的断路器,这仍是后续改进方向。
三、让 Reviewer 变好:历史事故进入 Eval
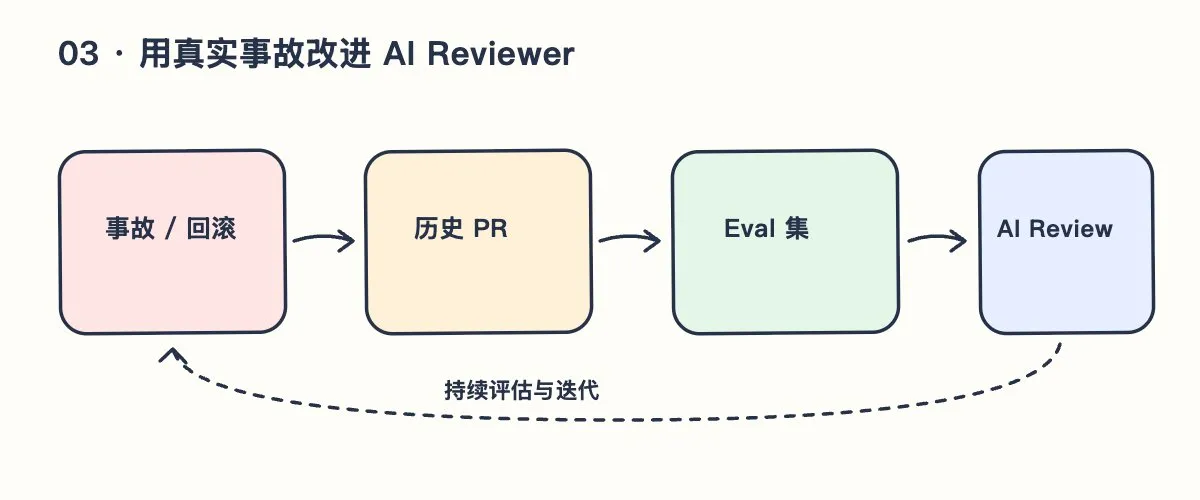
团队将历史事故、关联 PR、修复与回滚记录整理成 Eval 数据集,并由熟悉代码的工程师确认 Bug 和位置。Reviewer 每天跑这套评估集;模型、提示词或工具更新后也要重新评分。
除了发现真实 Bug,团队还监控误报:建议被修复、被认定错误、被视为刻意设计或被认为无关紧要的比例,以及在已知干净的 PR 上提出有害修改建议的情况。
好的 Reviewer 既要发现问题,也要控制噪声和修复成本。
四、避免 Agent Review 陷入死循环
团队曾遇到一个 CLI PR,一夜经历 50 多轮 Review 与修复。分析发现,约 59% 的反复发现的问题在第一轮时就已经存在。
为避免 Agent 作者与 Agent Reviewer 互相制造任务,团队采取了四种措施:
限制轮次:三轮之后要求作者重新评估方案。
聚焦增量:前几轮完整 Review 后,只审新 Diff。
按类别修复:一次解决同类问题,而非只修单点。
减少重复:已指出的发现不再反复提出。
这意味着 Review 的“收敛能力”也是一项关键工程指标。
五、工程师仍然负责什么?
AI 可以承担常规检查,但以下工作仍需要人的判断。
产品与范围决策:是否值得开发,是否存在更简单的方案,以及是否应该直接关闭一个 PR。
高风险代码和架构:认证、计费、发布、更新链路及可能被长期复用的设计,需要更严格的审查。
阅读验证证据:理解测试检查了什么、遗漏了什么,而不只是点击批准。
最终所有权:谁推动变更合并,谁就负责跟进结果与修复;事故复盘关注系统缺陷,而非简单归责个人。
对代码库知识的传播,也可以改为按需让 Claude 解释模块、整理调用链和生成架构说明,同时保留开放讨论和人工校验。
六、普通研发团队怎么采用?
建议从最容易验证价值的环节开始,逐步扩大范围。
先建设自验证:维护精简的 CLAUDE.md 和 REVIEW.md,让 Agent 自动运行既有检查并提供结果。
选择一个仓库试点 AI Review:结合安全审核、CI 门禁、PR 模板和 Review 轮次限制观察真实效果。
建立风险分级:优先对关键目录使用 CODEOWNERS 与分支保护。只有在质量数据稳定后,才考虑放宽低风险变更的人工批准。
打通发布与回滚:小批量变更、Merge Queue、Feature Flag、灰度及快速回退。
把事故变成评估样本:持续统计有效发现率、误报、Review 轮次、人工等待时长、回滚率与事故率。
其中,人工批准数量和等待时长衡量成本,回滚率与事故率作为质量护栏;不能仅通过削减审核环节来证明效率提升。
七、结论:质量保障能力必须跟上代码生成速度
Claude Code 团队的阶段性数据说明,高速开发与质量控制可以同时改进,但结果来自多层机制的共同作用,不能简单归功于某个模型或单一审核工具。
对多数团队而言,最值得优先复制的不是“零人工 Review”,而是三项基础能力:可靠的自动验证、按风险分配审核资源,以及问题发生后的快速回滚。
当 Agent 能更快地产出代码,研发工程真正需要扩展的,是验证、交付和恢复能力。
参考来源:Anthropic — Solving Code Review at Anthropic
本文为基于原文的结构化整理及实践建议,非逐句翻译。图示为概念简化,不代表全部内部执行细节。